别让 AI 去点鼠标 --- 为什么 GDIM + gdisdk 天生就是给 Agent 用的
发布时间:2026-10-09
一位工程师把一批岩土试验报告录进 GDIM,第一次用了半小时,第二次只用了不到十分钟。
差别不在 AI 变聪明了,而在于第二次——没让它碰鼠标。
一、一件日常工作小事
勘察项目的室内试验做完了,试验室交回四张标准格式的成果报告——土工、岩样、易溶盐、水分,加起来 30 条记录。
现在要把它们录进 GDIM。
这件事听上去毫无技术含量。但只要你真的坐下来录过一次,就会知道它有多磨人。
二、人工录入:一场与表单的消耗战
把镜头放慢,看看一个人到底在经历什么:
1. 逐条新增,机械动作重复 30 遍。点「新增」→ 弹窗打开 → 填字段 → 点「确定」→ 等列表刷新 → 再点「新增」。每一条都是完整一轮,没有批量入口。
2. 字段多,口径杂。土工试验一张表二十多个字段:含水率、密度、比重、孔隙比、饱和度、液限、塑限、塑性指数、液性指数、黏聚力、内摩擦角、压缩系数、压缩模量……任何一个填错位置都不会报错,只会在半年后的计算书里出问题。
3. 下拉依赖是个连环套。「勘探孔编号」是下拉框,数据源来自另一张表。孔没建,试验数据就选不了钻孔。于是你得先去把 13 个钻孔一条条建出来,才能开始录真正的试验数据——而这 13 个孔在原始报告里根本不是一张独立的表,纯粹是为了满足表单校验而造出来的额外工作量。
4. 单位和格式到处是暗坑。Excel 里密度写 g/cm³,系统标注 kg/m³;深度写成一个区间「21.3-21.5」,系统里是顶深、底深两个字段;「<0.04」表示低于检出限,数字字段存不进去,只能人为决定是留空还是写进备注。
5. 有些数据,表单根本装不下。孔隙率、烧失量、时代成因、电导率、负硬度……系统里没有对应字段,只能默默放弃。录完之后,没人说得清到底丢了什么。
6. 核对只能靠肉眼。30 行 × 二十几列。你要在 Excel 和浏览器之间来回切窗口,一格一格比对。看漏一格,代价由后面的设计计算承担。
7. 换个项目,全部重来。下一个项目、下一批报告,同样的动作再走一遍。没有任何东西被沉淀下来。
上面第 3 条里的那 13 个钻孔,在图 1 里长这样——它们不在任何一张原始试验报告里,纯粹是为了让表单的下拉框有东西可选,而一条条敲进去的。
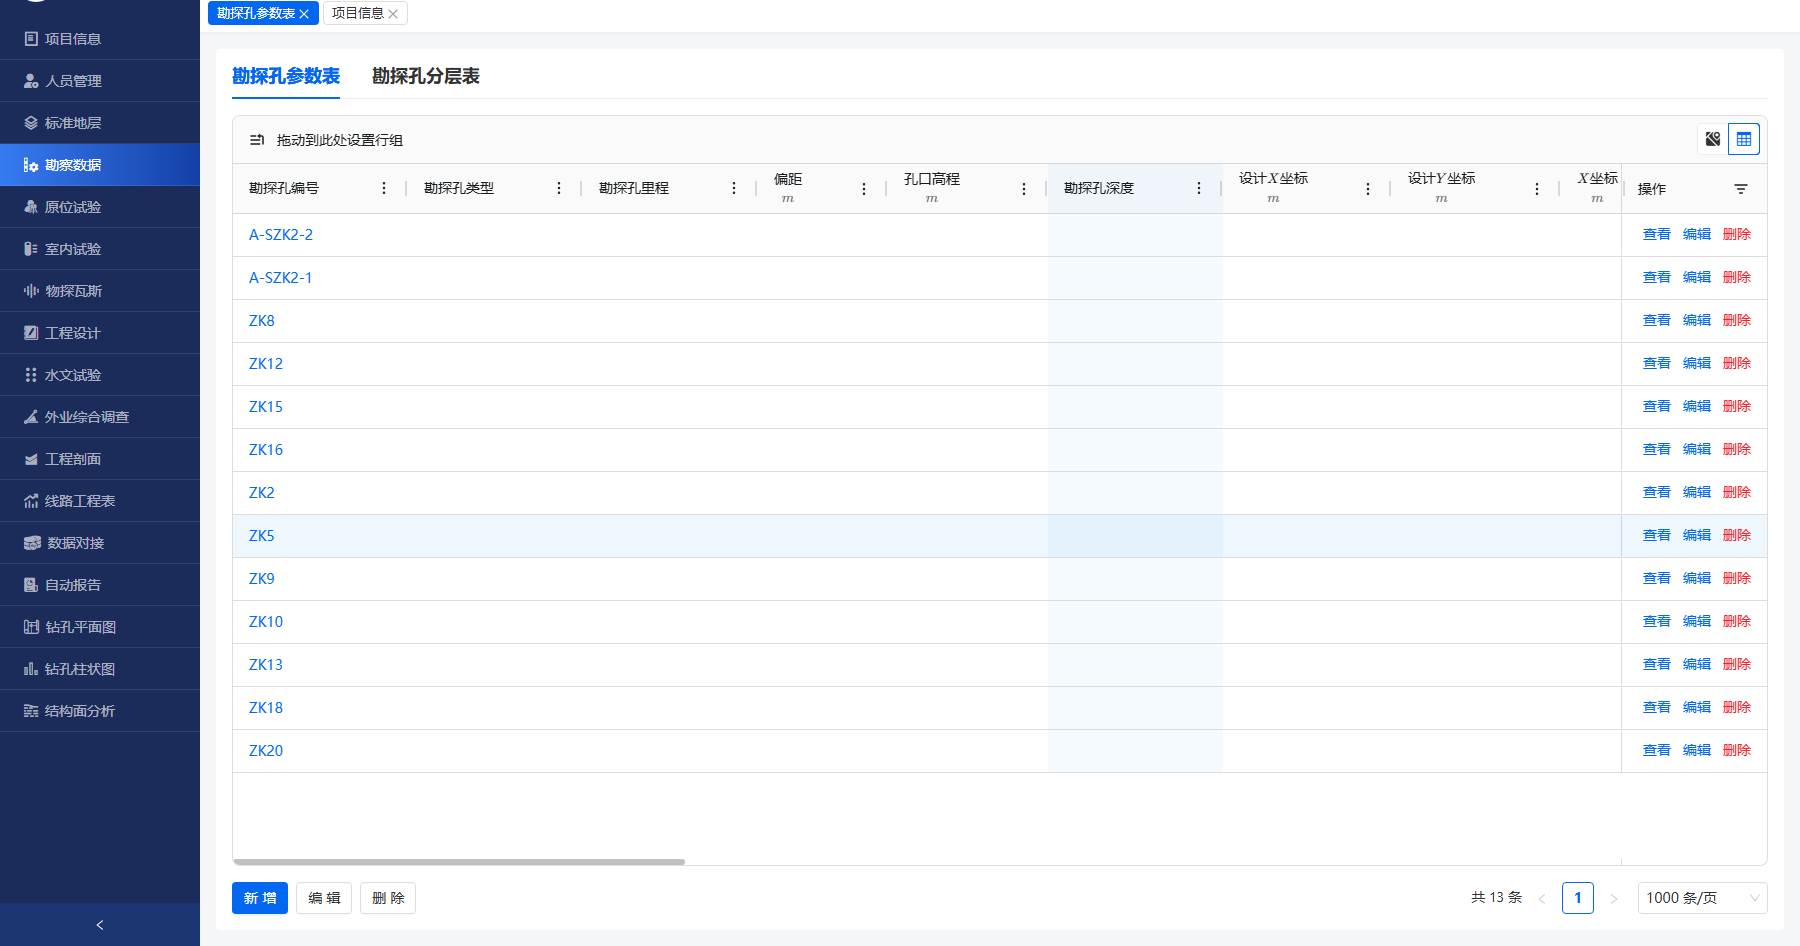
图 1 Web 路线中,试验数据录入前必须先逐条补录的 13 个勘探孔
这不是能力的问题,是界面的问题。表单是为「人一次填一条」设计的,它天然与「批量、重复、字段密集」的录入场景相冲突。
三、让 AI 来干?第一条弯路是「教它点网页」
既然是机械劳动,交给 AI 似乎是顺理成章的事。
于是有了第一次尝试:让 Agent 驱动浏览器,模拟人的操作去填表。技术上这叫 UI 自动化,思路很直觉——人怎么点,AI 就怎么点。
结果数据确实录进去了。但这条路暴露出的问题,比它解决的问题更有信息量:
- 弹窗里的「确定」按钮,真实鼠标点击完全没反应,必须绕过事件系统去执行 DOM 层的 click();
- 下拉框是虚拟滚动的,只渲染约 10 个选项,目标项在末尾时得先滚动再取;
- 弹窗提交后关闭了,DOM 却还留在文档里,靠「输入框是否还在」判断状态必然误判;
- 前端数字输入框会把 24.0 规范化成 24,Agent 用字符串比对校验,会把自己填对的值误判成错误;
- 判断「提交成功」的唯一可靠依据,是去读页面上那句「共 N 条」然后确认它 +1;
- 浏览器会话、登录态、超时、分批(每批还得卡在命令超时上限内)……每一个都是独立于业务逻辑的额外负担;
- 最致命的是:前端任何一次改版,整套脚本随时可能失效。
请注意——上面这些坑,人类一个都不会遇到。它们不是业务难点,是「机器模仿人」这件事本身的摩擦成本。
我们其实做了一件很荒谬的事:把一份结构化的数据,渲染成像素,再让 AI 从像素里把它读回来。
四、正解:给 Agent 接口,而不是给它鼠标
第二条路是 gdisdk:不碰浏览器,直接调 GDIM 的后端接口。
同样是那批数据,Agent 做的事变成了——登录取 token → 拉取数字模型的字段定义 → 用官方解析能力读 Excel → 按字段语义生成映射 → 预演校验 → 批量写入。
这中间真正关键的,不是「快」,而是 gdisdk 提供的一整套能力,恰好都长在 Agent 的强项上:
1. 字段定义可以编程获取
get_tpl_structure 能把数字模型里每张表的字段元数据完整取出来:名称、标题、单位、描述。
这意味着 Agent 不需要猜字段。它拿到的是「这个字段叫 natural_density,标题是天然密度,单位是 kg/m³」这种带语义的结构化描述——而语义匹配,正是大模型最擅长的事。
对比一下:UI 路线里 Agent 面对的是「页面上第 7 个输入框」,gdisdk 路线里它面对的是「单位标注为 kg/m³ 的天然密度字段」。两者的信息密度不在一个量级。
2. 校验发生在写库之前,且结果是结构化的
validation_level="full" 配合 auto_convert=true,会在写入前完成类型、单位、必填项的检查,问题以告警形式汇总返回,能定位到具体列。
对 Agent 而言,这是闭环的关键:它不只是「做了」,而是能立刻知道「哪里做错了」,然后自己修正。UI 路线里它只能提交完再去数页面上的条数。
3. 有 dry-run,可以低成本试错
--dry-run 让 Agent 在不改动数据库的前提下完整预演一遍。
对 Agent 来说这几乎是必需品——它没有人类的直觉,它靠的是「试一下、看结果、再调整」这个循环。没有预演能力的接口,等于让 Agent 蒙着眼睛走钢丝。
4. 配置即代码,人类可以审阅
映射关系、转换规则、清洗策略全部落在一个 import_config.json 里。
这一点常被低估。它意味着 Agent 的决策是可审查的:人不必逐行核对数据,只需 review 一份配置——「试验编号映射到样品编号」「深度区间拆成顶深底深」「这两个 CO₂ 字段不许互串」。信任闭环由此建立:AI 负责执行,人负责拍板。
5. 批量写入 + 结构化错误返回
一次调用写入整张表,raise_error=false 时单表失败不中断其余表,返回的是结构化的错误字典。
于是失败不再是灾难:Agent 能定位到具体是哪张表、什么原因,修完重跑即可。配合 gdim_id 机制,重跑还能安全地转成更新而非重复插入。
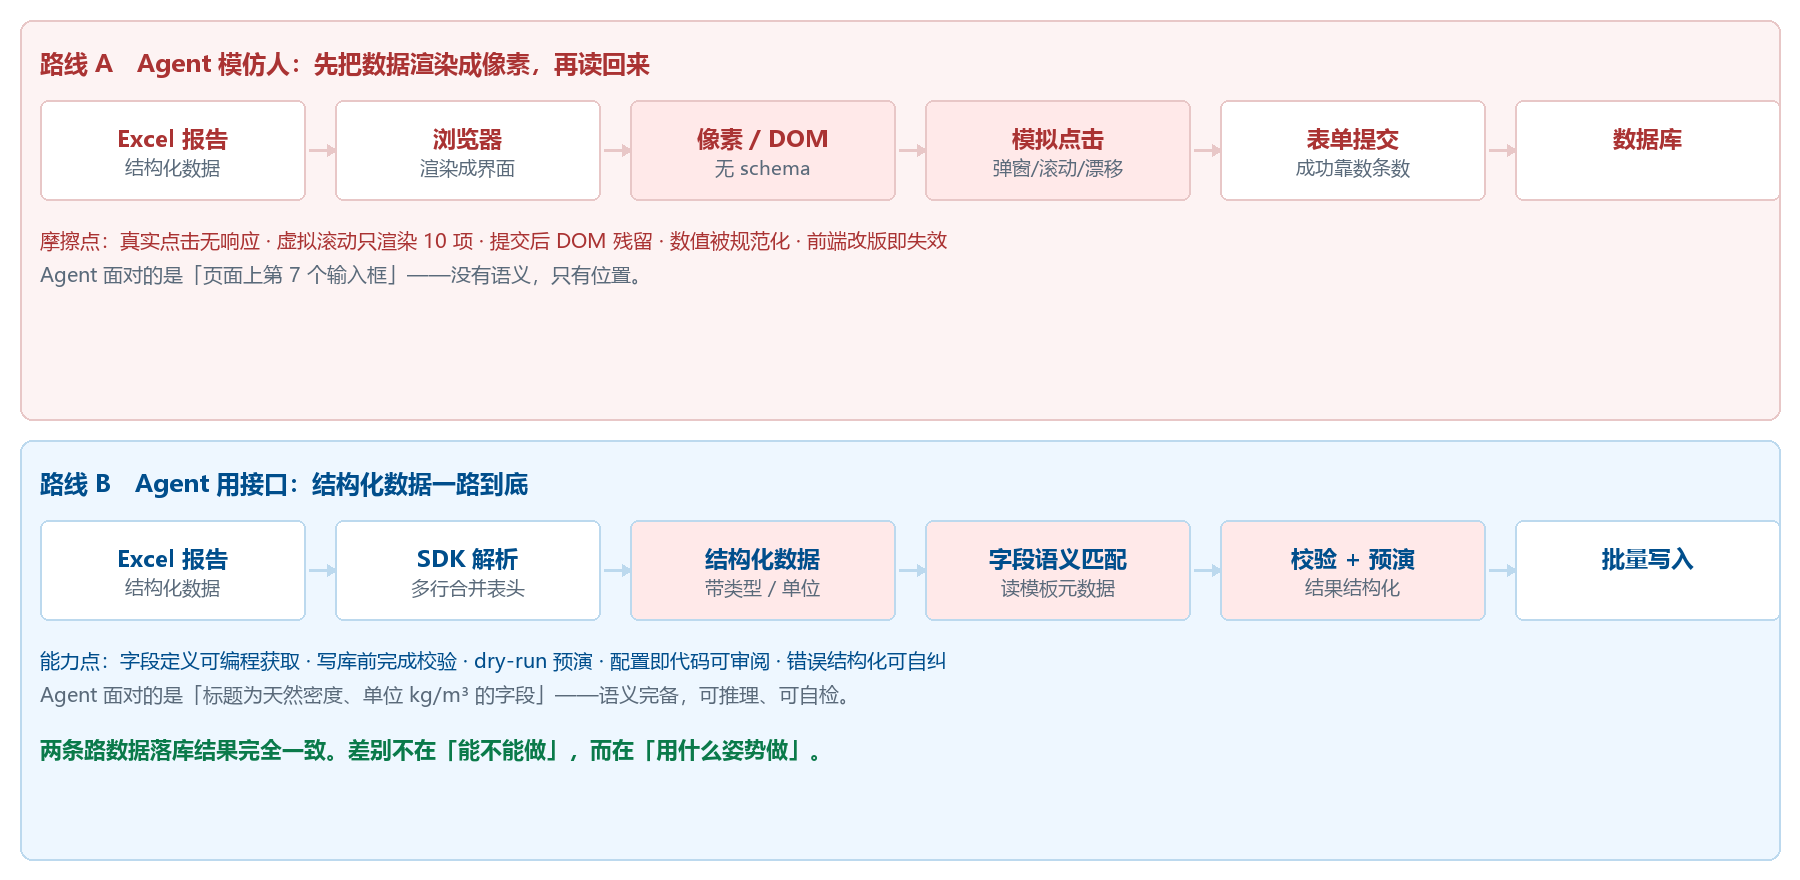
图 2 两条路线的信息形态对比:上为「模仿人点网页」,下为「用接口直写」
五、实测:同一批数据,两条路的差距
|
维度 |
gdisdk(API 直写) |
Web UI 自动化 |
|
接入层级 |
调用后端数据写入接口 |
驱动浏览器点击表单 |
|
前置依赖 |
无,直接写目标表 |
需先补录 13 个勘探孔 |
|
实际处理量 |
30 条试验数据 |
43 条(含 13 条前置钻孔) |
|
全程耗时 |
约 8–9 分钟 |
约 33 分钟 |
|
校验方式 |
写库前完成,结果结构化 |
提交后回读页面文本 |
|
失败处理 |
单表失败不中断其余表 |
单条失败需人工定位 |
|
前端变更敏感度 |
低,接口稳定 |
高,改版即可能失效 |
|
可复用性 |
配置可版本化、跨项目复用 |
每次重新登录跑完整条链路 |
|
环境依赖 |
一个 Python 环境 + SDK |
浏览器、驱动、多环境变量、进程管理 |
数据落库结果两者完全一致——图 3 把源报告的每一列、每一行,与 GDIM 系统中的落库结果逐一对应,可以看到两者在数据层面完全等价。这说明差异不在「能不能做」,而在「用什么姿势做」。
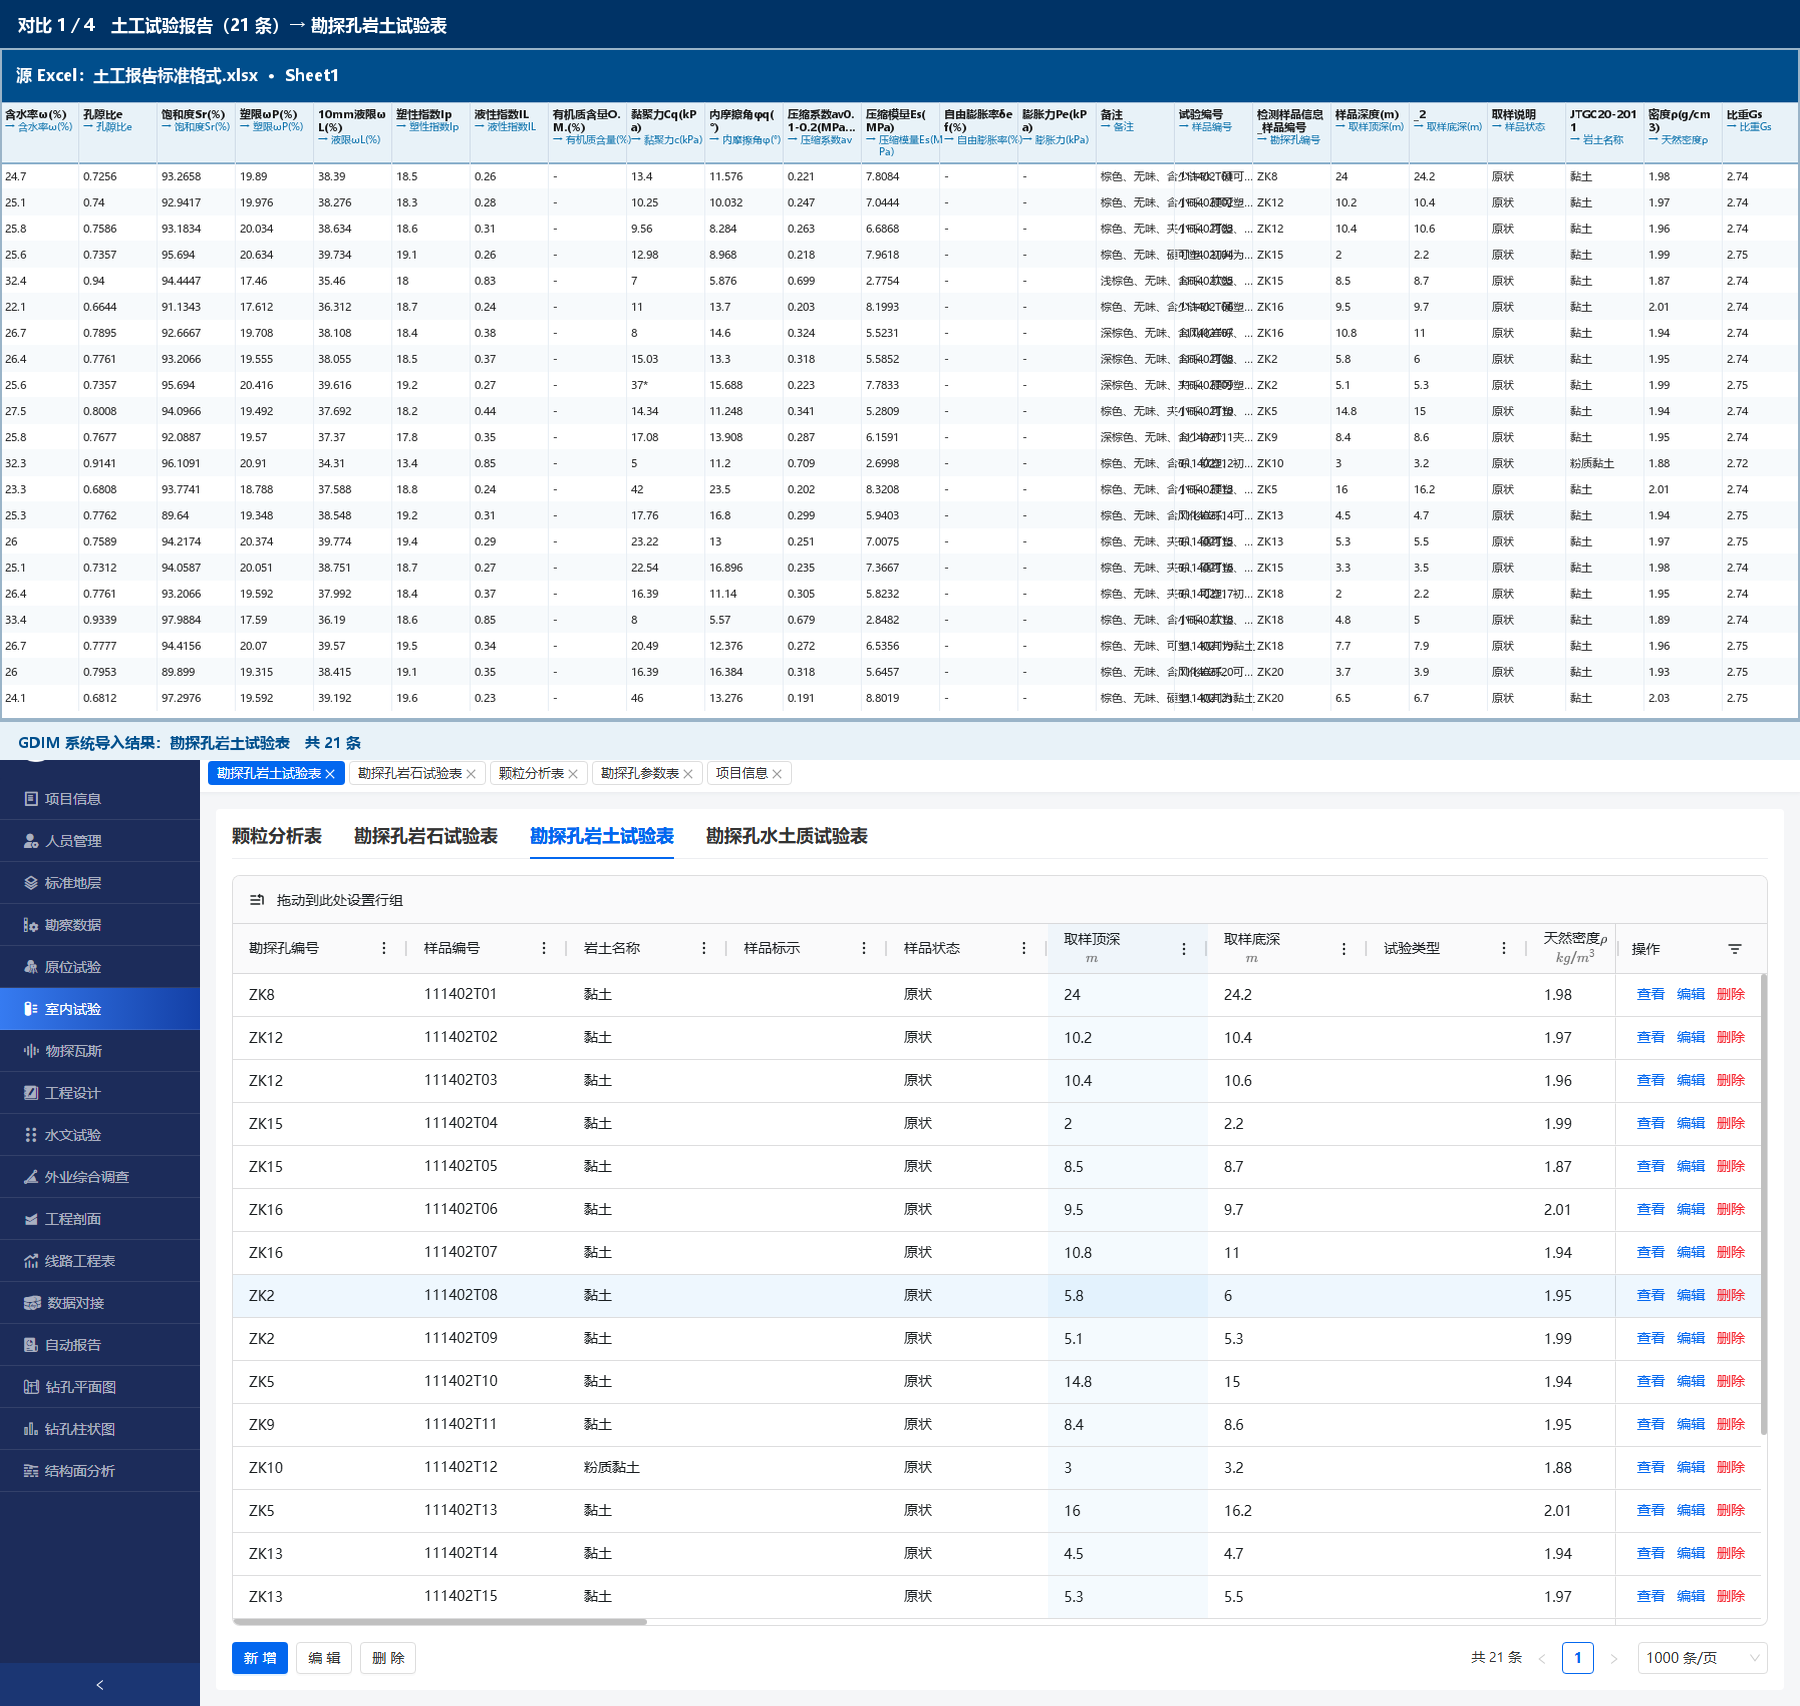
图 3 土工试验报告与 GDIM 落库结果逐列对应,数据完全一致
六、结论:界面是给人的,接口是给 Agent 的
回顾这两条路,真正的分野在于一个判断:
UI 是为人类感官设计的,API 是为程序逻辑设计的。
让 Agent 去点网页,等于先让它学会用鼠标,再让它干活。
而 GDIM 的价值,恰恰在于它不只是个录入系统。它是一个 API 优先的数据平台:有 token 鉴权、有可编程的模板结构、有写库前的完整校验、有预演机制、有结构化的错误返回。gdisdk 做的,是把这套能力原封不动地搬到 Python 里。
于是「把 Excel 数据搬进 GDIM」这件事,性质彻底变了——
从「教会机器模仿人」,变成「让机器做它本来就擅长的事」:
读结构、理解语义、按规则校验、批量执行、出错就重试。
这不是把 AI 塞进旧流程,而是流程本来就该长这样。GDIM + gdisdk,天生就是给 Agent 用的。

